
## 摘要 本文解读 CoRL 2025Oral论文《X-Sim: Cross-Embodiment Learning via Real-to-Sim-to-Real》。该论文提出**真实—仿真—真实real-to-sim-to-real框架 X-Sim**通过融合**人类视频中的物体运动跟踪**、**照片级真实 Gaussian Splatting 仿真**与**在线自标定的图像条件扩散策略**让机器人只观看一段无动作标签的人类视频就能学会操作任务其特别之处在于**完全不采集任何机器人遥操作数据**——它不翻译人的动作只在仿真里复现动作所造成的物体运动。实验表明**该框架在 5 个真实任务的 10 次真机 rollout 上取得 83.3% 的平均任务进度部署期在线标定后进一步提升到 90.7%比不依赖仿真的手部跟踪基线高出 30 个百分点以上**基线 Hand Mask 26.7%、Object-Aware IK 60.0%并且用 1 分钟人类视频达到 90% 成功率媲美 10 分钟机器人演示的 70%为跨具身机器人学习与真实到仿真的数据生成提供了重要借鉴。 **视频讲解**[点击观看 B 站视频](https://www.bilibili.com/video/BV1iSYe6CEPr) [TOC] ## 论文基本信息 | 项目 | 内容 | |---|---| | 标题英文 | X-Sim: Cross-Embodiment Learning via Real-to-Sim-to-Real | | 标题中文 | X-Sim用「真实—仿真—真实」闭环从人类视频学会机器人操作 | | 作者 | Prithwish Dan, Kushal Kedia, Angela Chao, Edward W. Duan, Maximus A. Pace, Wei-Chiu Ma, Sanjiban Choudhury | | 机构 | Cornell University | | 会议 | CoRL 2025Oral | | arXiv | [arXiv:2505.07096](https://arxiv.org/abs/2505.07096) | | 项目网站 | [portal-cornell.github.io/X-Sim](https://portal-cornell.github.io/X-Sim/) | ## 背景与动机 机器人策略的主流训练范式是模仿学习用遥操作采集大量图像—动作对再训练行为克隆策略。问题在于**数据采集本身就是瓶颈**。要让策略覆盖新的任务与新环境就得反复teleoperation遥操作即使已经有 DROID、Open X-Embodiment 这类大规模机器人数据集与 OpenVLA、π 系列这类机器人基础模型in-domain 数据依然不可或缺。 人类视频看起来是天然的解药YouTube 上有取之不尽的演示采集成本几乎为零还天然覆盖真实环境。但它有一个致命缺陷——**没有机器人动作标签**。已有的三条绕行路线都有各自的硬约束 - **重定向人手运动**假设人手的运动对机器人是可行的assumes that human movements are feasible for the robot to replicate … which is rarely the case in practice。这在实践中很少成立。 - **视觉域修补**PHANTOM / SHADOW 一类方法用黑 mask 盖住人手再在推理时同样遮住机械臂试图消除训练与测试之间的视觉域差。但当人手与机械臂的形态差异过大时剩下的信息只有物体在哪里。 - **成对数据翻译**Vid2Robot、MimicPlay 一类方法需要成对的人类—机器人演示采集昂贵且难以规模化。 真实到仿真到真实这条线已经进入仿真学习策略但仍有关键缺口RialTo 用点云部署并需要真实数据ResiP 需要在真机上先训好一个图像策略再做残差学习与本文最相关的 **Human2Sim2Robot** 虽然同样从单段人类视频出发却在推理时依赖精确的 6D 物体位姿跟踪——而遮挡、深度噪声与视觉模型误差会让微小跟踪误差直接把策略推出训练分布。 X-Sim 的突破口是一次问题重述**动作虽然不可得但动作所造成的物体运动是可以完整测量的**而物体运动与执行者的具身形态无关。 ## 研究主线从问题到结论 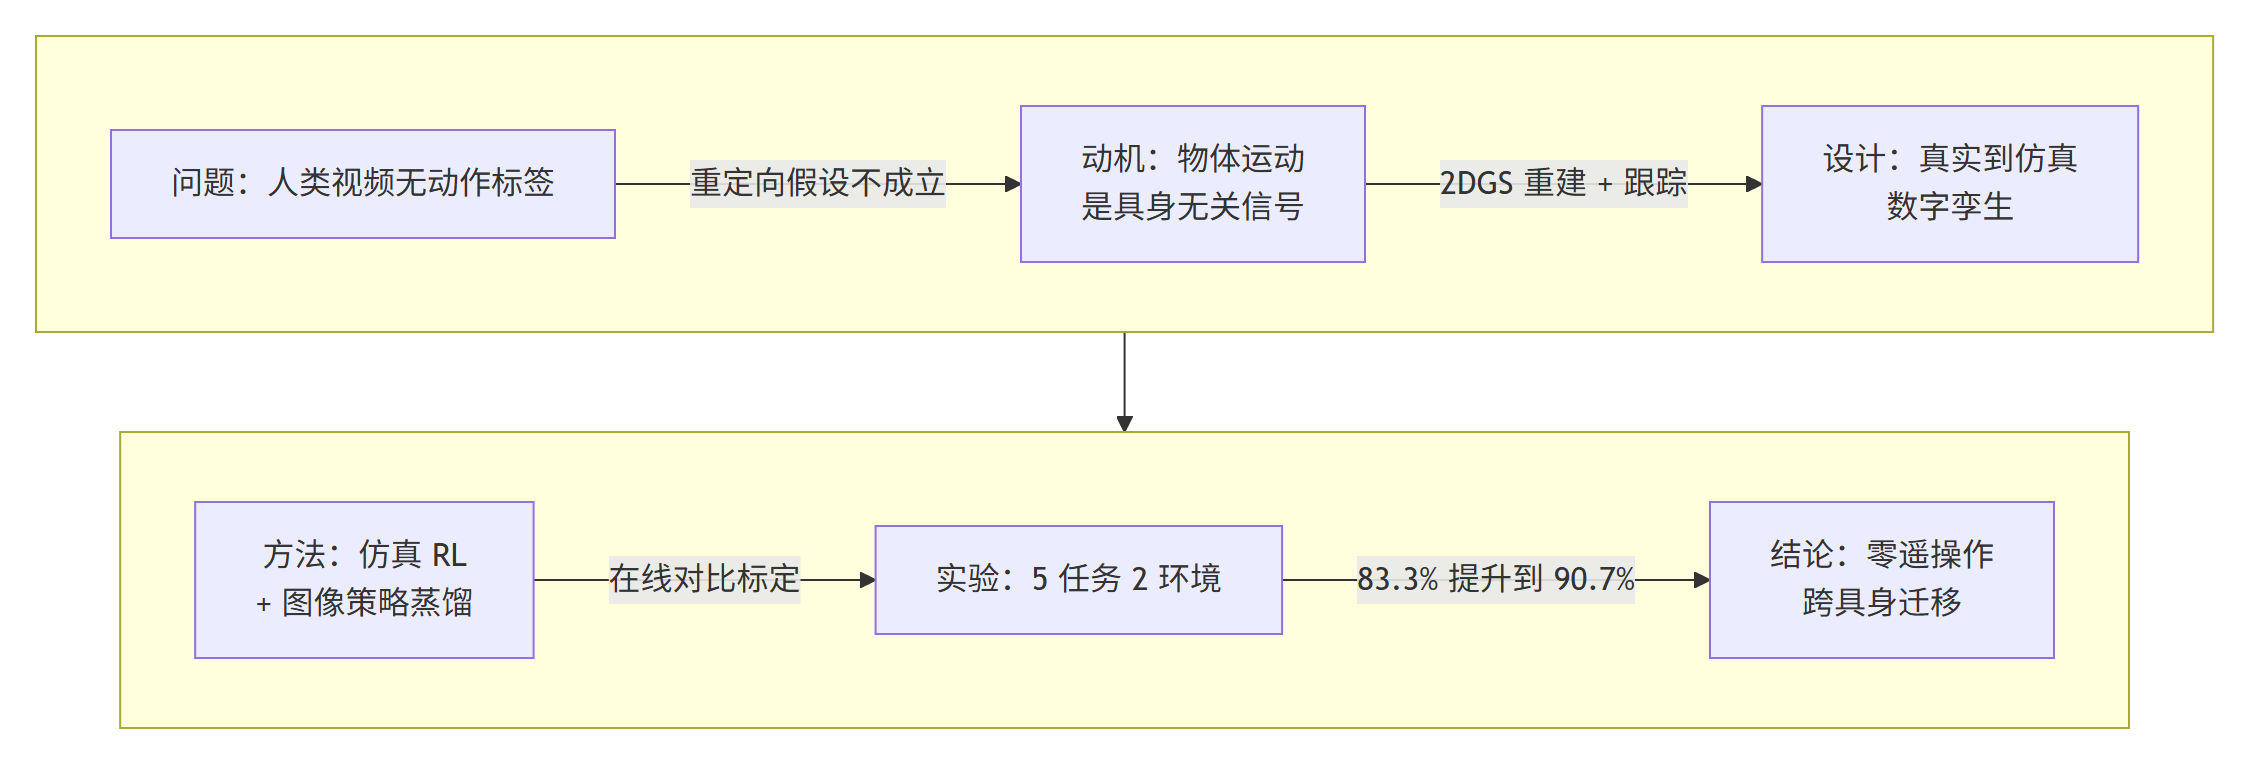 **图 11X-Sim 的研究主线Mermaid 流程图。把「人类视频无动作标签」这一问题经由「物体运动是具身无关的监督信号」这一动机转化为真实到仿真、仿真强化学习与在线标定三阶段方法最终在 5 个真机任务上验证。** ## X-Sim 基准设计真实—仿真—真实三阶段框架 X-Sim 的框架由三个阶段构成每个阶段解决一个具体障碍。 **阶段一 · 真实到仿真Real-to-Sim** 解决没有动作标签用 off-the-shelf 的 3D 扫描 App 得到待操作物体的高保真网格用 Segment Anything 生成首帧掩码再用 FoundationPose 在整个视频上跟踪每个物体的位置与旋转得到六自由度物体轨迹同时用 2D Gaussian Splatting 从多视角图像重建环境的几何与外观直接导入 ManiSkill 仿真器。 **阶段二 · 在仿真中生成机器人动作** 解决人类动作与机器人动作不可比把人类的物体轨迹降采样为若干里程碑waypoint定义物体中心的稠密奖励用 PPO 训练一个可观测特权状态物体位姿、目标位姿、末端位姿、夹爪开合、抓取标志的策略再把它 rollout 成大量图像—动作对。 **阶段三 · Sim-to-Real** 解决仿真与真实的观测差异把特权状态策略蒸馏成只看单张 RGB 图像的条件扩散策略并在部署后引入在线自标定用真实与仿真的配对观测继续对齐观测编码器。 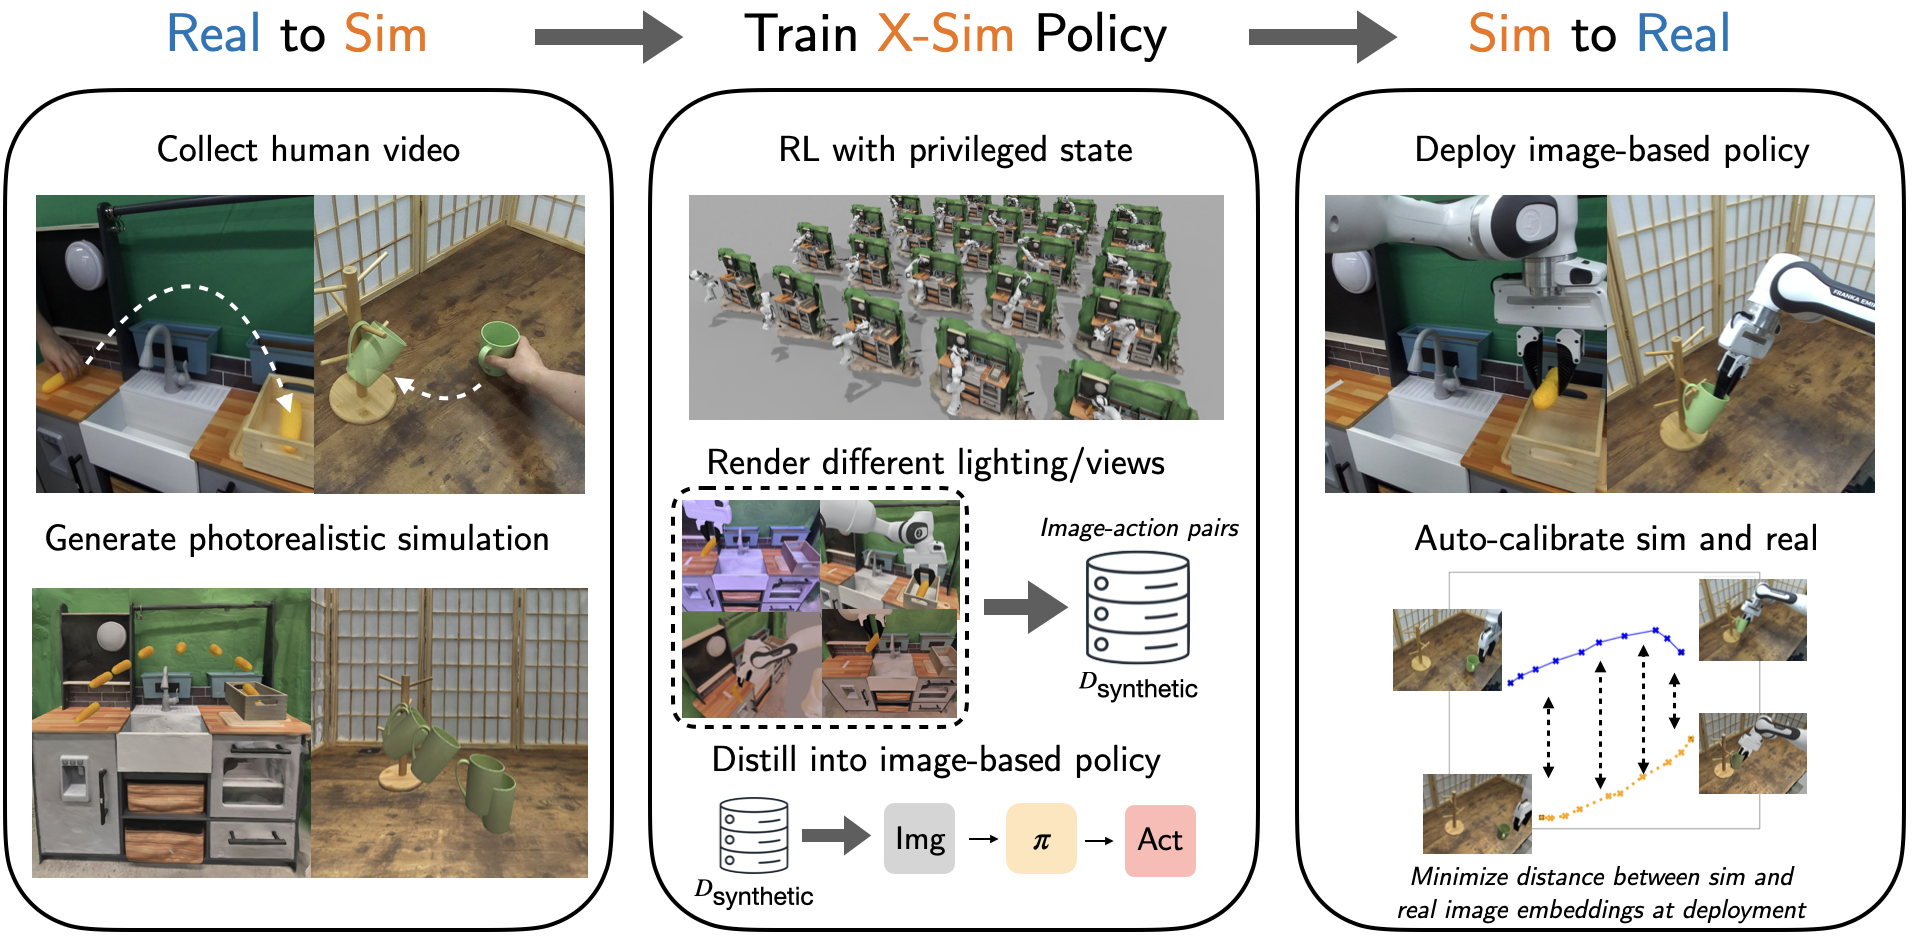 **图 1X-Sim 总览。左侧 Real-to-Sim 从人类视频提取物体状态并重建照片级仿真中间在 GPU 并行环境中用特权状态训练强化学习策略再收集多样的图像—动作数据蒸馏出图像条件策略右侧图像策略部署到真机其观测编码器在测试期用真实与仿真的配对观测自动标定。** 值得注意的是论文对真实到仿真环节的成本做了明确的量化环境的多视角视频采集**不到 2 分钟**单个物体的 Polycam 扫描**不到 1 分钟**网格尺度目前手工对齐也可以换成自动标定方法。 ## 分类全景 从如何绕开动作标签这个角度看跨具身学习可以分成四条路线X-Sim 选择了其中最彻底的一条。 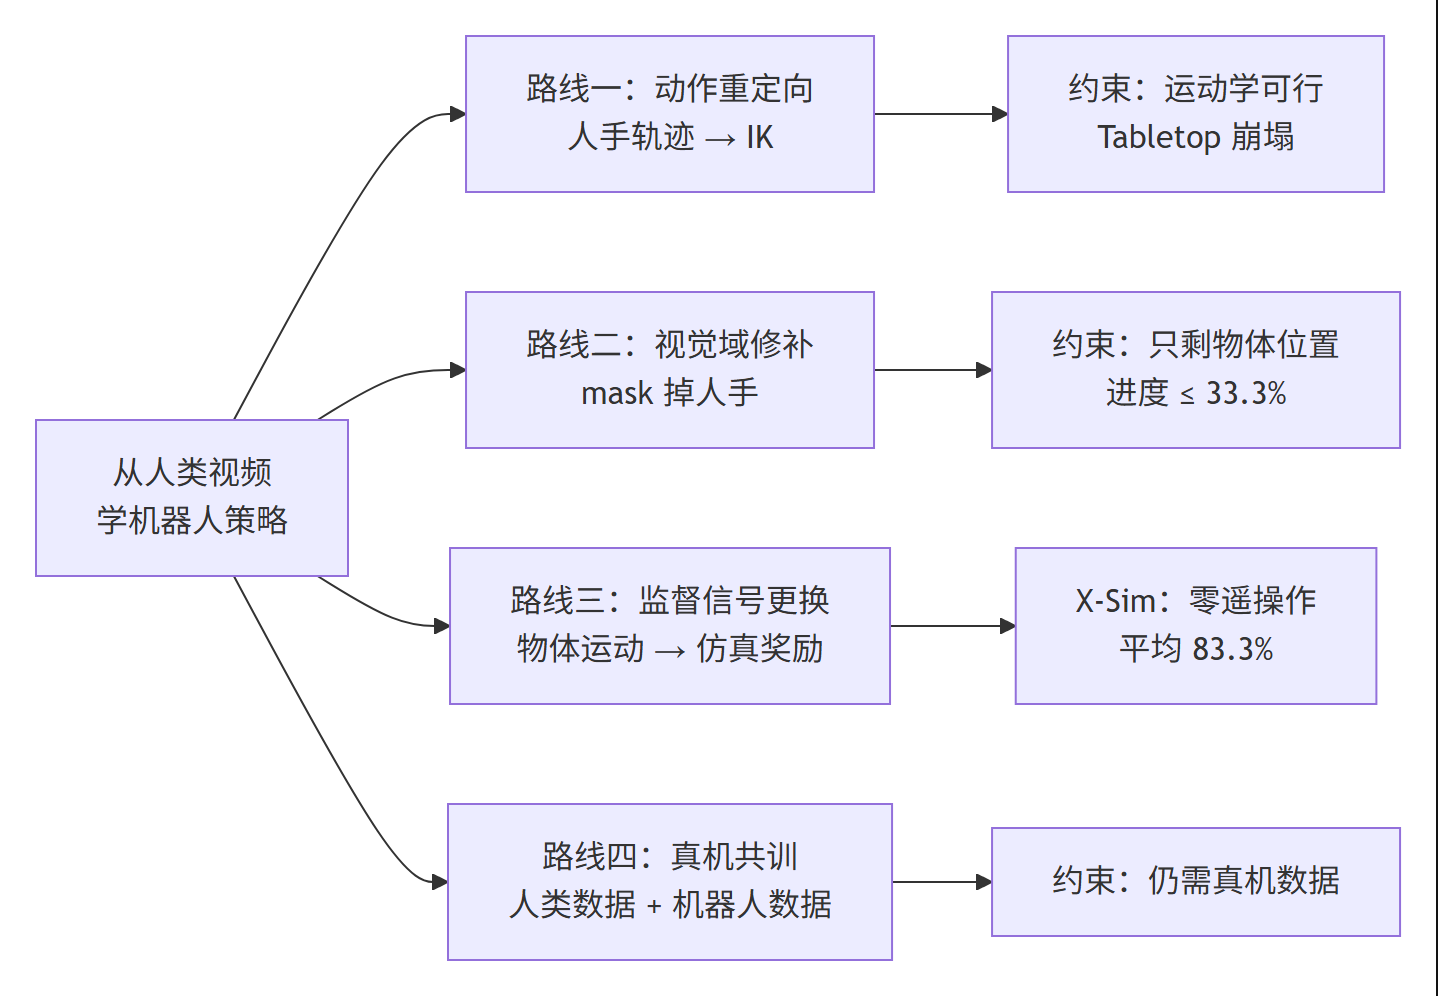 **图 12四条技术路线的取舍对比Mermaid 分类图。前两条路线受制于运动学可行性与视觉域差第四条的共训路线仍需真机数据只有第三条把监督信号本身换掉才同时摆脱了这两个约束。** ## X-Sim 方法细节奖励设计、合成数据与在线标定 ### 物体中心奖励把物体轨迹翻译成奖励 有了物体轨迹任务就被表述为目标条件强化学习问题。论文把轨迹降采样为 $N$ 个里程碑每个里程碑 $s_H^B$ 给出所有被跟踪物体的期望位姿奖励由两部分相加而成$r_{\rm obj} r_{\rm approach} r_{\rm goal}$。 其中靠近项把末端执行器拉向下一件待操作物体形式为 $r_{\rm approach} 1 - \tanh(k d_{\rm obj})$$d_{\rm obj}$ 是末端执行器与当前目标物体的距离$k$ 是常数缩放因子。目标项则同时惩罚位置与旋转偏差形式为 $r_{\rm goal} (1 - \tanh(\alpha_d d_{\rm pos})) (1 - \tanh(\alpha_\theta d_{\rm rot})) 2 i_{\rm waypoint}$其中 $d_{\rm pos}$ 度量当前物体位姿与目标里程碑位姿之间的欧氏距离$d_{\rm rot}$ 度量两者的四元数夹角$\alpha_d$ 与 $\alpha_\theta$ 是由演示自动计算的缩放因子$i_{\rm waypoint}$ 是当前里程碑序号作为推进任务的进度奖励。还有一个关键设计当物体位姿进入 $\epsilon$ 阈值观测中的 desired_goal 就切换到下一个里程碑于是单步定位问题自然变成了多步操作。此外还有稳定项 $r_{\rm static}$、完成奖励 $r_{\rm success} 1$以及可选的抓取奖励 $r_{\rm grasp}$。 这套公式与把人类的手映射到机器人的手有一个本质区别**它从不要求人类与机器人执行相同动作**只要求最终物体的位姿序列一致。正因如此人类可以用任何抓取方式、任何速度完成任务机器人的动作可以完全不同。 ### 合成数据随机化换来的鲁棒性 RL 策略只收敛到一条轨迹是不够的。论文在 rollout 时系统性地随机化物体初始位置噪声 $\pm 0.025$ m、初始旋转噪声 $\pm \pi/8$ rad、机器人初始关节角噪声 $\pm 0.02$ rad、相机位置与目标位置变化 $\pm 0.03$ m、4 组光照预设每个任务收集 **500 条**合成演示并且只保留成功轨迹。同一段人类演示由此被扩展成覆盖大量视角与状态条件的图像—动作数据集。 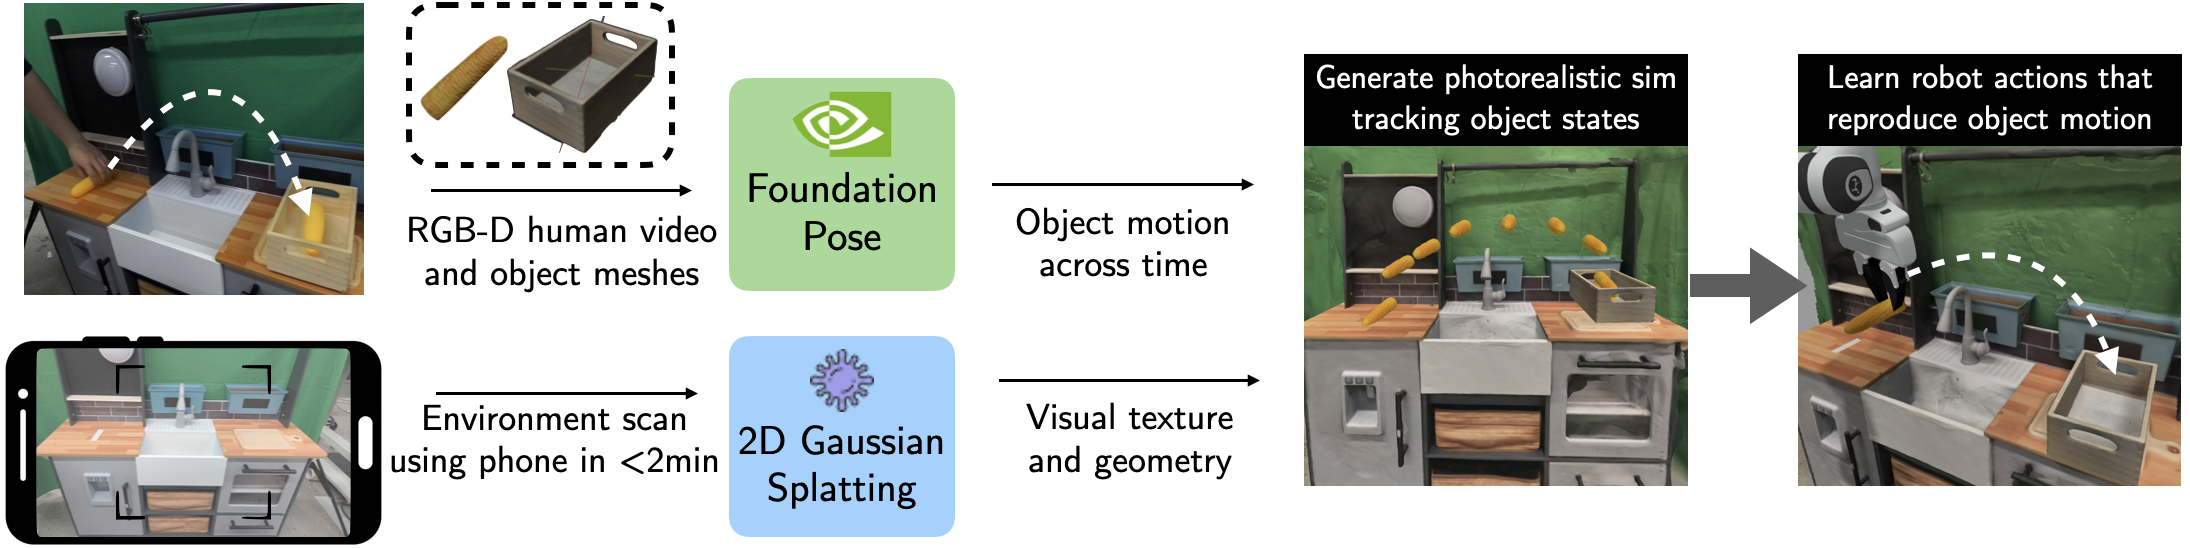 **图 2Real-to-Sim。X-Sim 用多视角图像重建几何准确的照片级真实环境并从 RGBD 人类视频中逐帧跟踪物体运动用以定义稠密的物体中心奖励函数从而在仿真中训练 RL 策略。** ### 在线自标定连失败轨迹也是对齐样本 即使仿真照片级真实3D 重建与渲染的瑕疵仍会留下观测差异。论文的做法是初始策略部署到真机后收集真实闭环 rollout 的观测——**包括失败的 rollout**——然后把机器人放回同样的初始状态在仿真中重放完全相同的机器人轨迹得到成对的真实/仿真图像 $D_{\rm paired}$。 训练时的损失是标准的扩散行为克隆损失加上一项对比项$\mathcal{L}_{\rm cal}$ 用 InfoNCE 的形式把同一机器人状态在真实与仿真下的嵌入 $s(\phi(o^{\rm sim}), \phi(o^{\rm real}))/\tau$ 拉近、把错配的对推远其中 $\phi$ 是策略的图像编码器、$\tau$ 是温度系数、$s$ 是余弦相似度权重为 **0.1**。这一步不需要任何标注也不关心 rollout 是否成功。 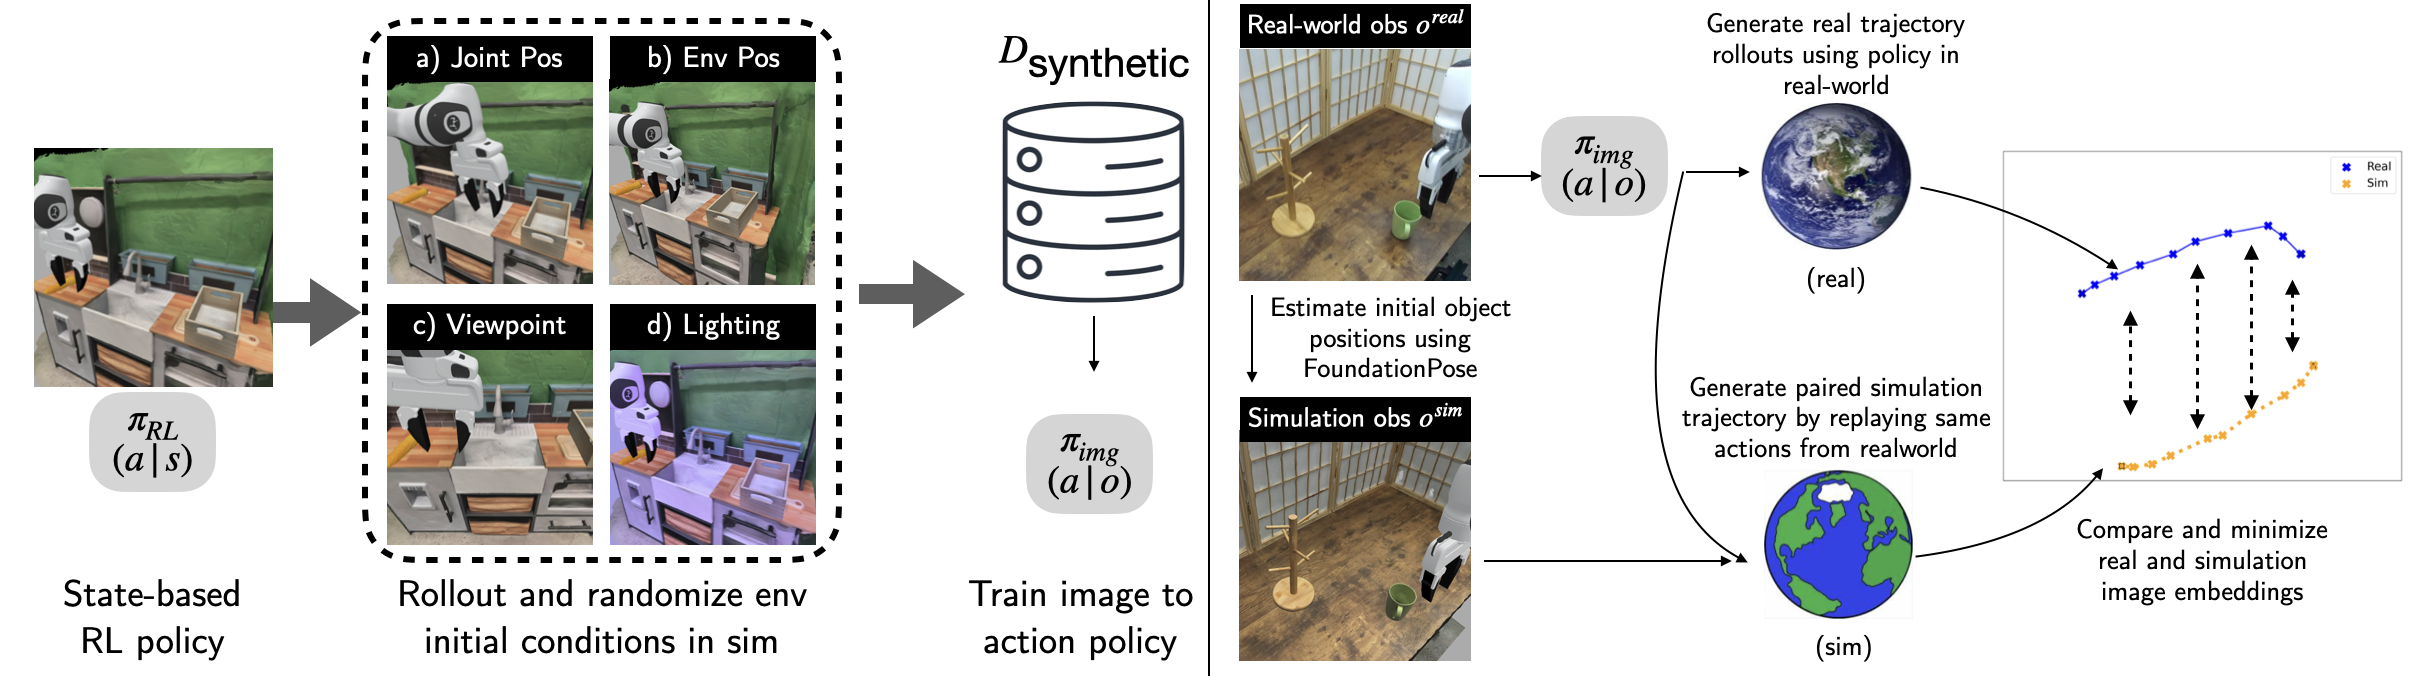 **图 3Sim-to-Real。左用物体位姿、机器人关节、相机与光照的多种随机化生成合成图像—动作数据集把特权状态策略蒸馏为图像条件策略。右部署期把真实策略 rollout 搬回仿真重放得到真实/仿真配对图像用其差异最小化视觉域差。** ## 实验设计与结果 实验平台是 **7-DOF Franka** 机械臂配平行夹爪覆盖 **2 个真实环境**Kitchen 厨房与 Tabletop 桌面与 **5 个任务**人类视频用 ZED 2 立体相机录制对动作与抓取风格**不加任何约束**。主指标是**平均任务进度Avg. Task Progress**按阶段给部分分需要抓取的任务分解为「靠近正确物体 33.3% → 成功抓稳 66.7% → 变换到目标位姿 100%」非抓取任务把后两段分给「转对」与「移对」。每个方法在每个任务上做 **10 次**真机 rollout物体初始位置相对演示状态做轻微扰动。 三个基线分别是 **Hand Mask**PHANTOM 风格训练与推理都遮住手/机械臂、**Object-Aware IK**从人类视频提取手—物相对轨迹再用逆运动学回放给机器人与 **Human2Sim2Robot**在仿真中学习但推理时依赖 6D 物体位姿跟踪。三者都不使用本文的仿真数据生成流程。 ### 主结果五个任务的平均任务进度 | 任务 | Hand Mask | Object-Aware IK | X-Sim | X-Sim (Calibrated) | |---|---|---|---|---| | Mustard Place抓取放置 | 23.3 | 80.0 | 93.3 | **93.3** | | Corn in Basket抓取放置 | 26.7 | 86.7 | **100.0** | **100.0** | | Shoe on Rack抓取放置 | 30.0 | 66.7 | 83.3 | **96.7** | | Letter Arrange非抓取 | 26.7 | 36.7 | 83.3 | **93.3** | | Mug Insert精密插入 | 26.7 | 30.0 | 56.7 | **70.0** | | **平均** | 26.7 | 60.0 | 83.3 | **90.7** | 数值单位为百分比读取自论文 Fig. 2每格为 10 次真机 rollout 的平均任务进度。  **图 4五个评测任务的可视化。从抓取放置芥末瓶换位、玉米入篮、鞋上架到非抓取操作字母对齐与精密插入杯柄插入任务越靠后人类与机器人的执行差异越大。** 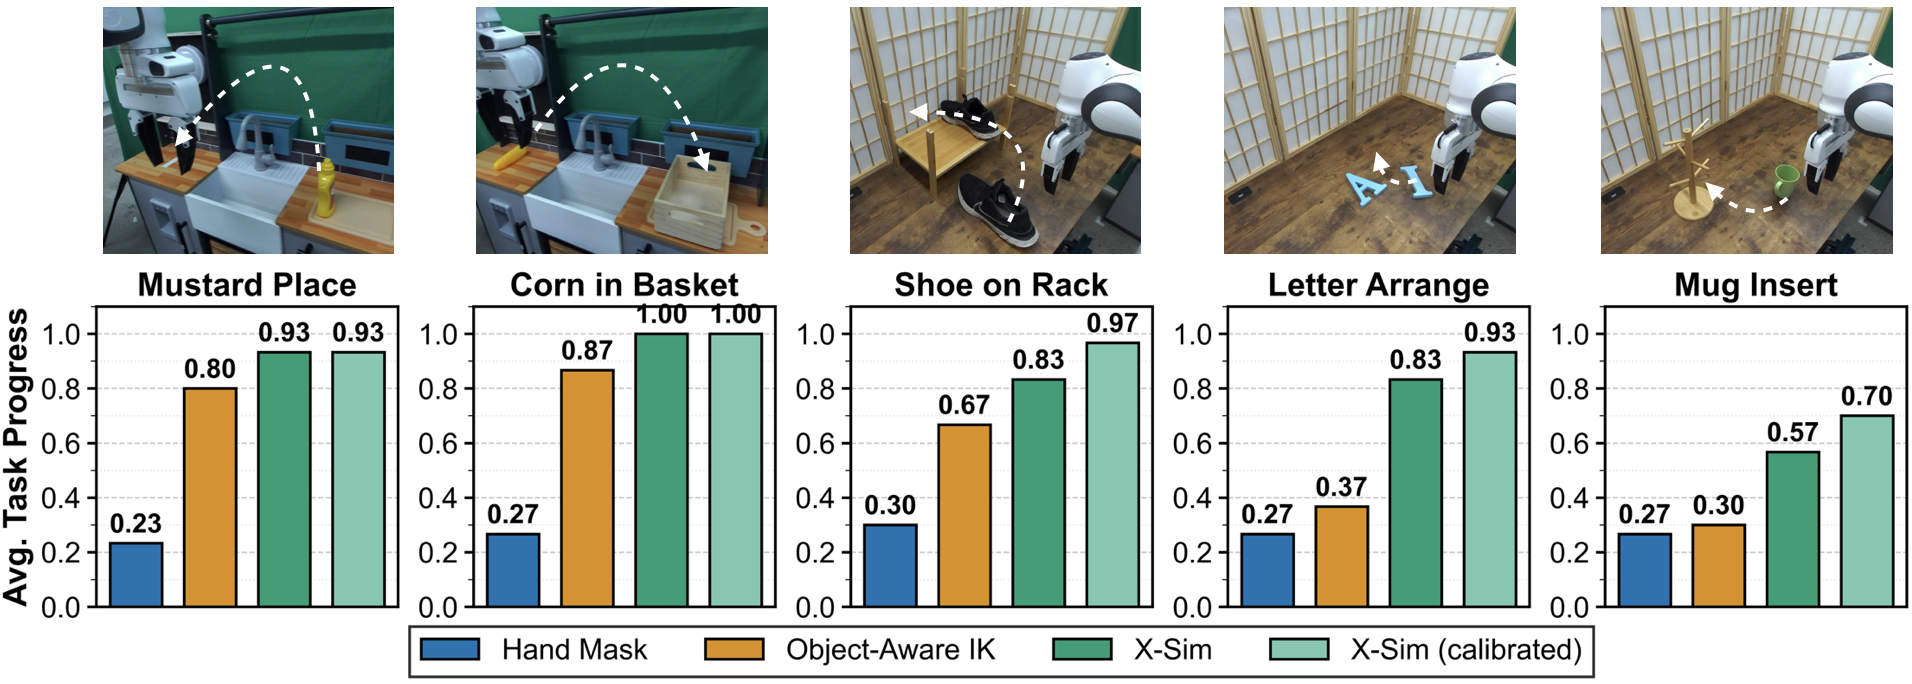 **图 5真机任务表现。5 个任务 × 2 个环境上的平均任务进度X-Sim 与其标定版本一致优于试图重定向人手运动的手部跟踪基线图中上方为各任务的示意草图。** ### 在线标定从 83.3% 到 90.7% | 任务 | X-Sim | X-Sim (Calibrated) | 增益 | |---|---|---|---| | Mustard Place | 93.3 | 93.3 | 0.0 | | Corn in Basket | 100.0 | 100.0 | 0.0 | | Shoe on Rack | 83.3 | 96.7 | 13.4 | | Letter Arrange | 83.3 | 93.3 | 10.0 | | Mug Insert | 56.7 | 70.0 | 13.3 | | **平均** | 83.3 | 90.7 | **7.4** | 标定在所有任务上都只增不减平均提升约 **8%**在最难的精密插入任务 Mug Insert 上提升 **13%**。论文特别强调这个过程的两个性质它**不依赖 rollout 是否成功**a procedure that is agnostic to success/failure甚至可以从失败中受益。这在实践中意味着标定不需要额外的专家介入只要让策略在真机上跑十条轨迹论文中为 10 条即可。 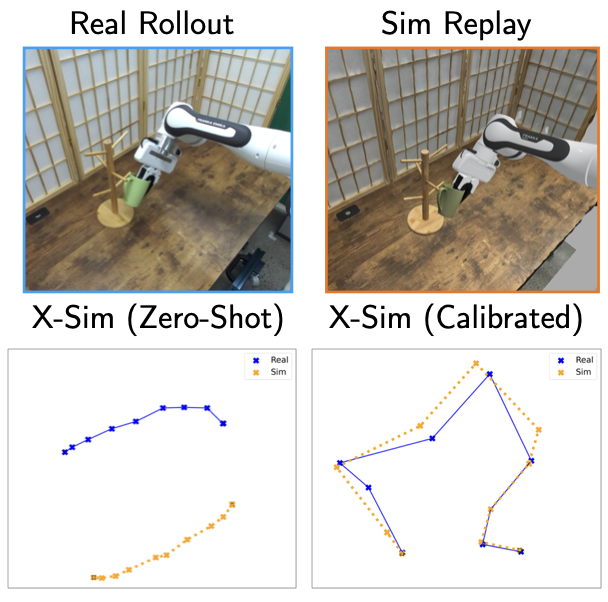 **图 6Sim-to-Real 标定。对单条 rollout 比较 X-Sim 图像嵌入在标定前后的 t-SNE 分布标定后真实与仿真的嵌入对齐更好说明编码器不再过拟合域特有属性而是聚焦任务相关特征。** ### 失败模式两条基线为什么上不去 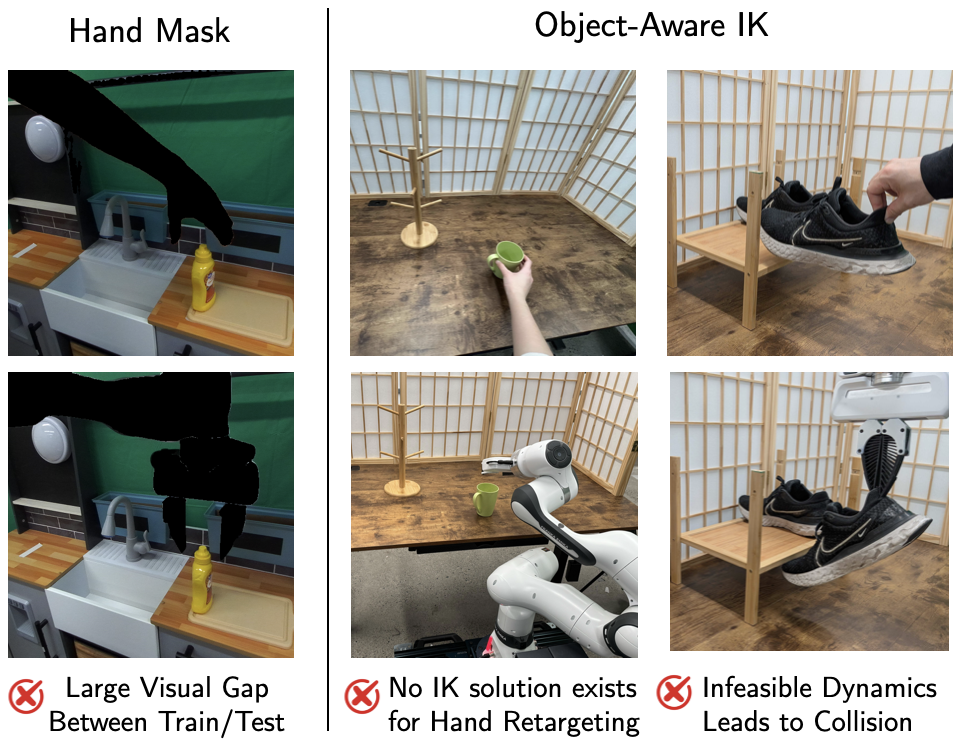 **图 7手部重定向的失败模式。Hand Mask 因人类与机器人之间显著的视觉域差而失败即便动作对机器人物理可行Object-Aware IK 在用人手动作直接模仿时因运动学或动力学不可行而失败。** 两条失败模式恰好对应了两条路线的根本约束。**Hand Mask 在全部 5 个任务上从未突破 33.3%**也就是从未越过“靠近”这一阶段——它从人类视频中保留下来的信息只有物体的位置。**Object-Aware IK** 在 Kitchen 任务上可以到 80% 以上Mustard Place 80.0%、Corn in Basket 86.7%因为厨房任务里人手与机械臂的执行风格接近但到了 Tabletop 任务就崩溃Letter Arrange 只有 36.7%Mug Insert 只有 30.0%因为人的手可以做的动作Franka 的平行夹爪在运动学与动力学上做不到。 X-Sim 则完全没有这类约束它不复现动作只复现结果。 ### 数据效率1 分钟人类视频 vs 10 分钟机器人演示 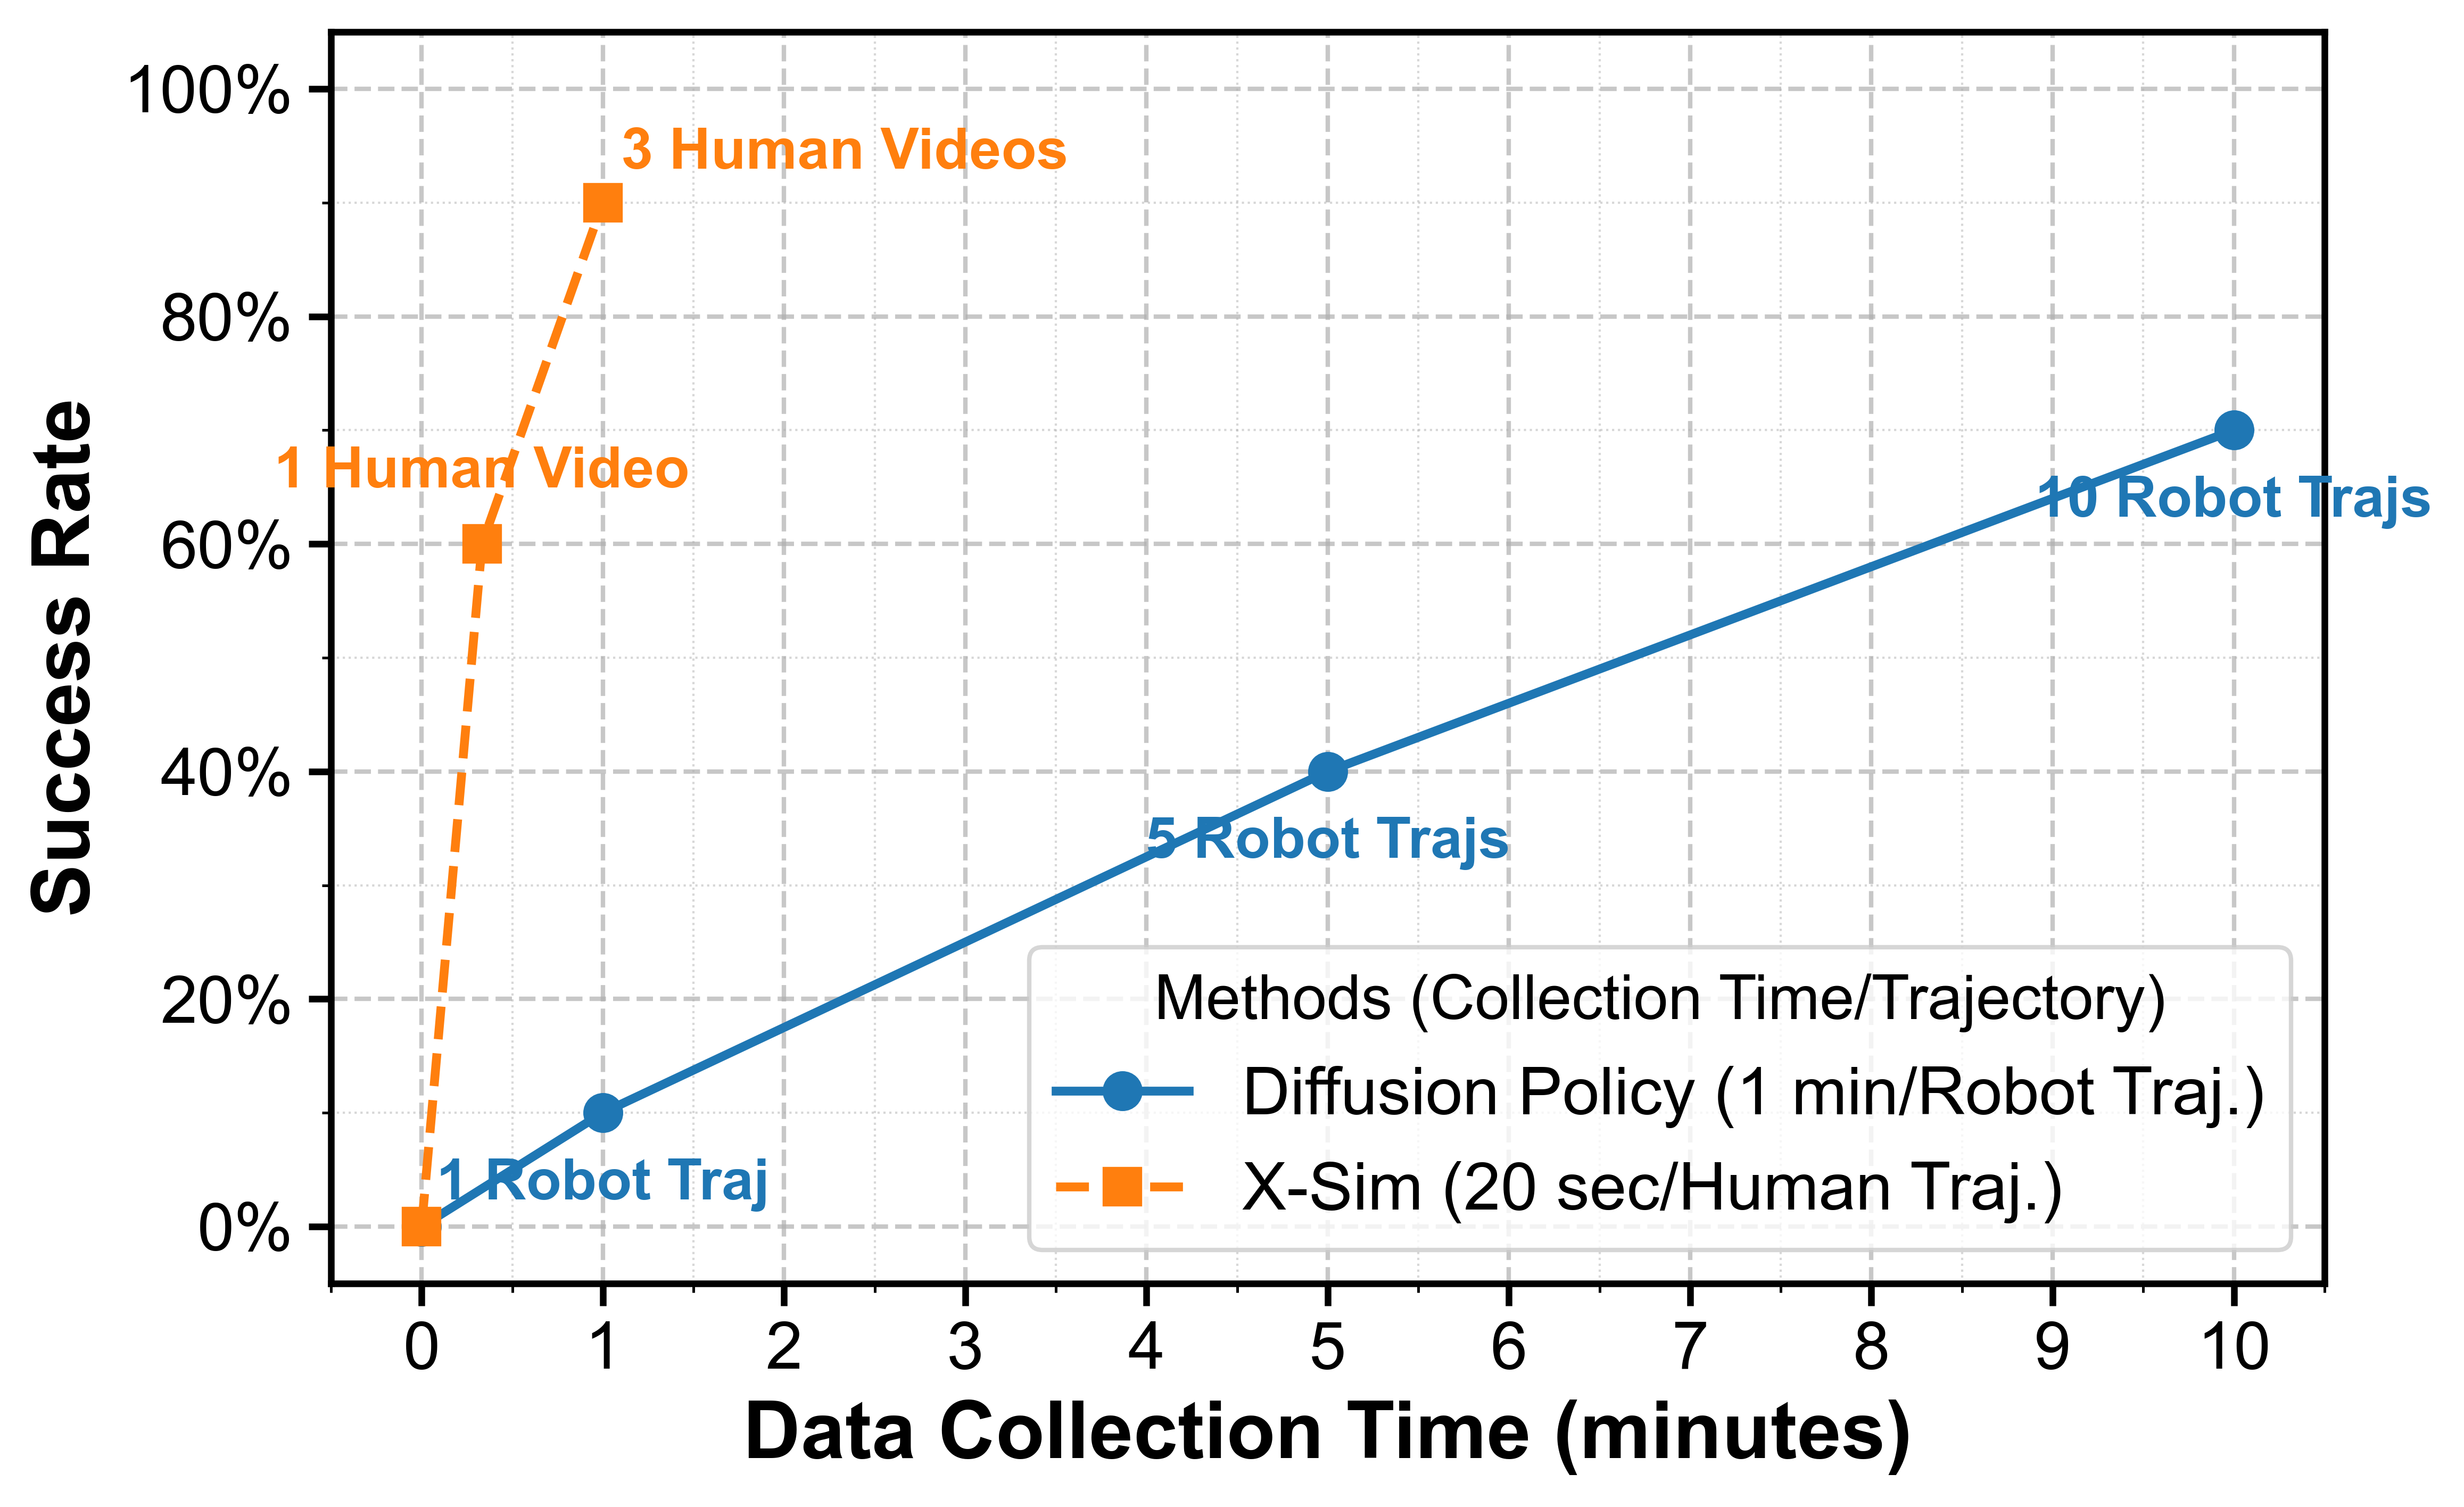 **图 8数据效率。X-Sim 随数据采集时间的扩展效率高于基于机器人遥操作的行为克隆在 Mustard Place 上用 10 倍更少的采集时间取得可比的成功率。** 论文把 Mustard Place 改造成一个初始状态分布被大幅放宽的版本让覆盖整个分布变得昂贵。在同样的评测分布上 - **行为克隆**需要 **10 分钟**机器人遥操作演示成功率 **70%** - **X-Sim**只需 **1 分钟**人类视频3 段 × 20 秒成功率 **90%**。 差一个数量级的采集时间成功率反而更高。原因有两层一是采集效率本身——一段人类视频 20 秒一次机器人演示 60 秒二是仿真可以对物体位姿做任意扰动用极低成本扩大状态覆盖。 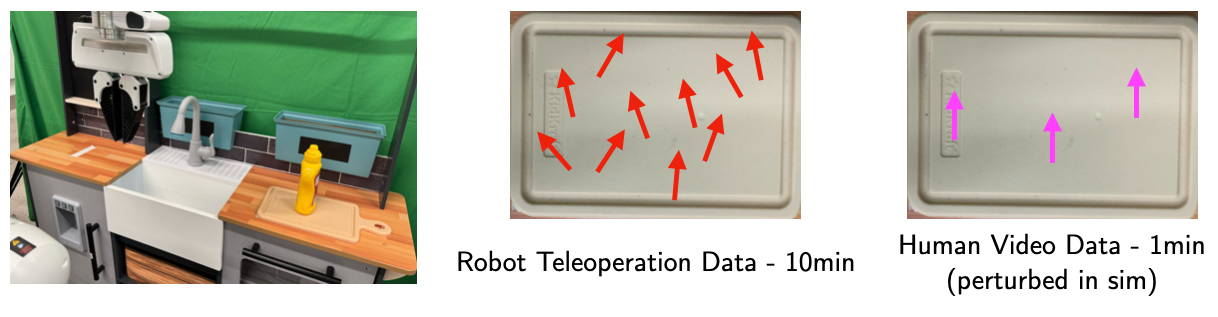 **图 9数据效率消融的训练状态可视化。机器人遥操作数据的采集需要 10 分钟人类视频只需要 1 分钟在仿真中物体的起始位姿还会被进一步扰动既让 RL 策略更鲁棒也让合成数据覆盖更广。** ### 鲁棒性多视角数据几乎零成本 图像条件策略对视角极其敏感通常需要为每一个新视角重新采集数据。X-Sim 的做法是利用仿真渲染任意视角的能力用 Side 与 Frontal 两个视角的数据训练策略。结论是单视角训练的策略换到另一个视角会大幅退化而把两个视角的数据合起来训练不仅两个视角都变好对训练中没见过的第三个视角也有明显泛化。 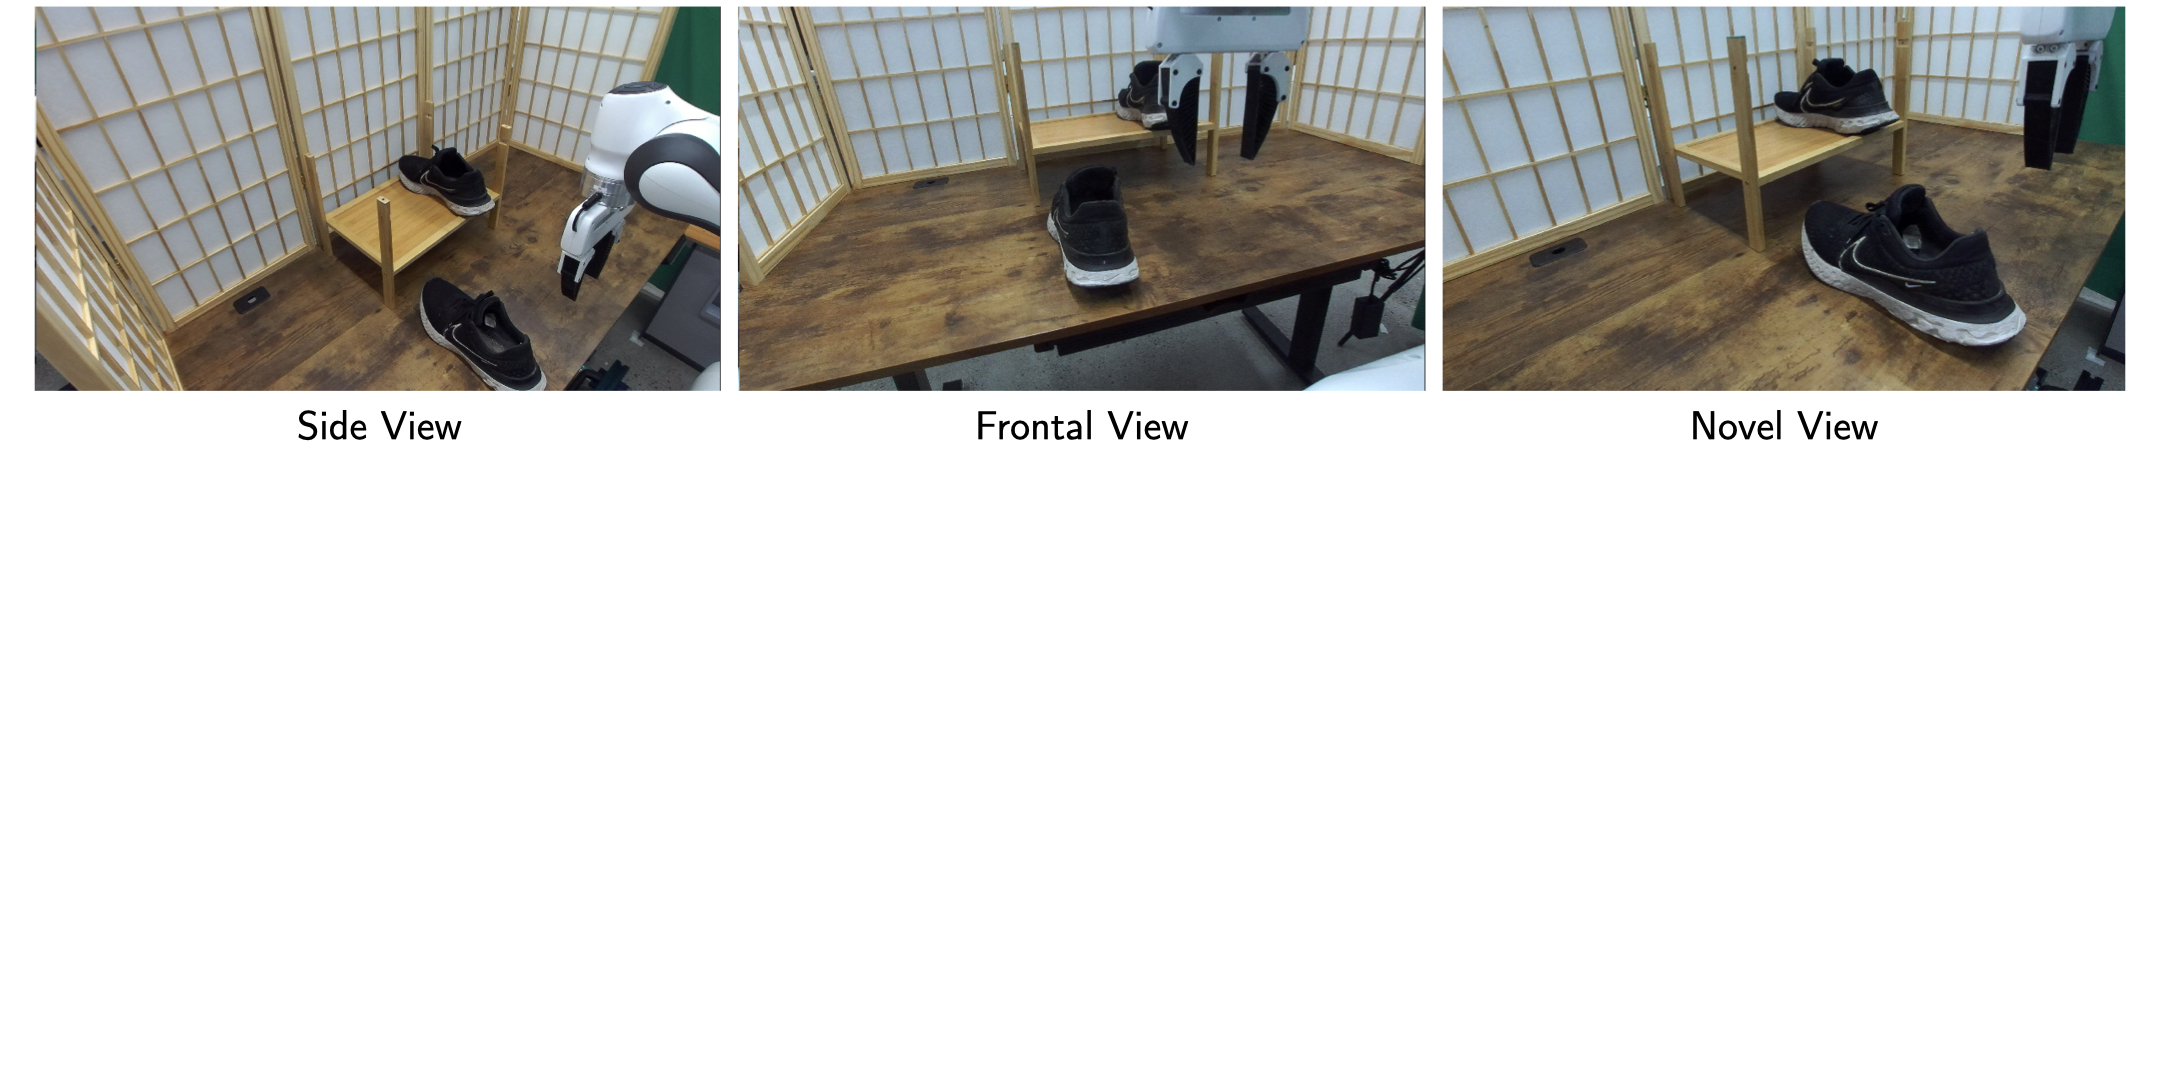 **图 10视角变化的可视化。仿真可以按任意视角渲染轨迹因此多视角数据几乎是零成本实验在 Side / Frontal / Novel 三种相机视角上评估 Shoe on Rack 任务。** ## 结果对比总结 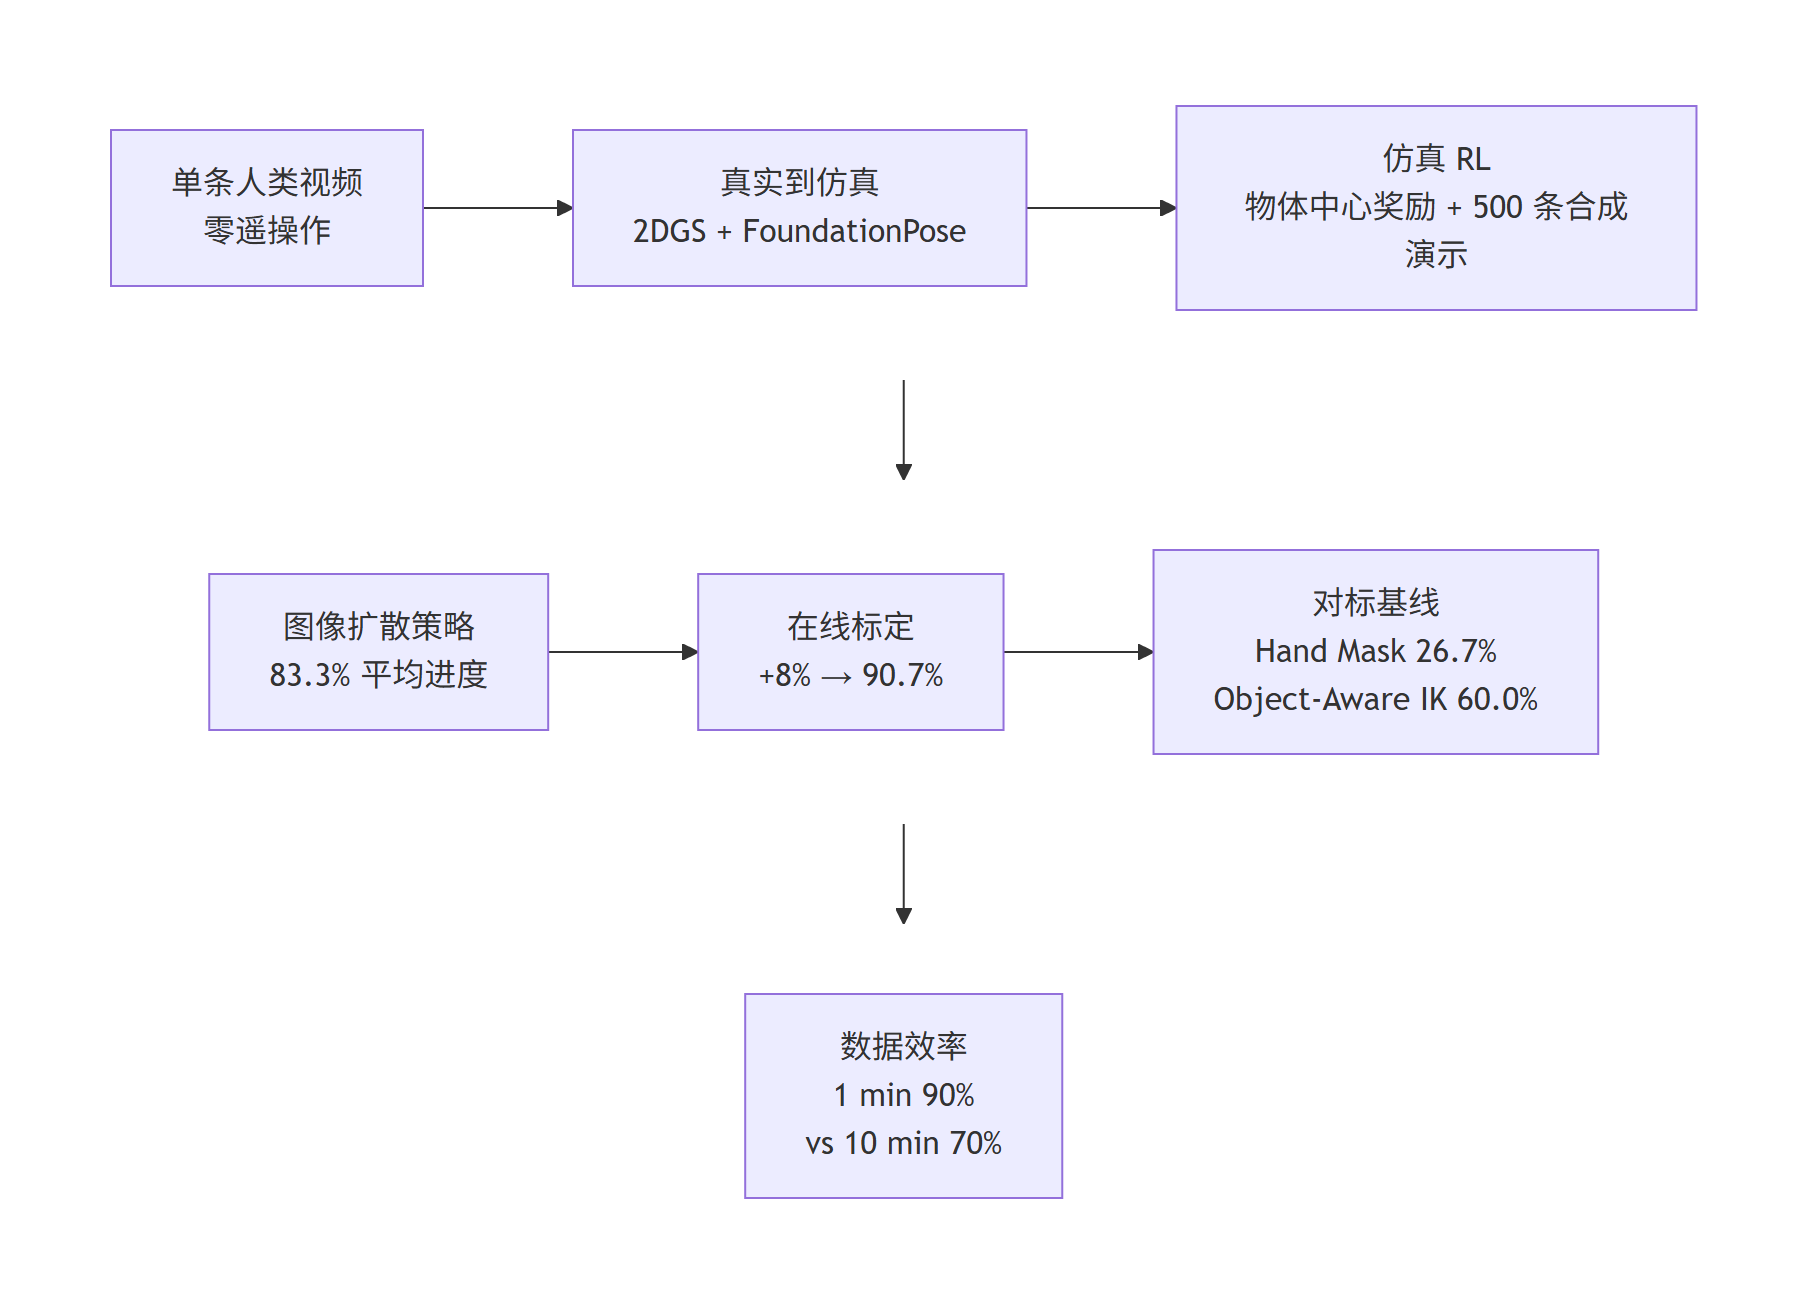 **图 13结果链条Mermaid 流程图。从单条人类视频出发经由真实到仿真与仿真强化学习图像策略达到 83.3%在线标定后到 90.7%显著超过两个手部跟踪基线并在数据效率上取得一个数量级的优势。** ## 关键发现 - **物体运动是跨具身可迁移的监督信号**。论文在引言中把它作为核心洞察明确写出while human actions are unavailable, the object motion they produce provides a dense supervisory signal for training robot policies in simulation。 - **纯视觉修补存在结构性上限**。Hand Mask 在 5 个任务上的平均进度为 26.7%**从未突破 33.3%** 的靠近阶段说明抹掉人手之后剩下的信息不足以支撑操作。 - **执行不匹配是重定向路线的真正瓶颈**。Object-Aware IK 在 Kitchen 上可达 86.7%但 Tabletop 任务掉到 30%–36.7%**同一方法在两类环境间相差 50 个百分点以上**。 - **在线标定能从未成功的轨迹里学习**。标定平均带来 **7.4 个百分点**在最难的 Mug Insert 上带来 **13.3 个百分点**且不使用任何专家标注。 - **数据效率差一个数量级**。1 分钟人类视频达到 90% 成功率10 分钟机器人演示只有 70%采集环节的 20 秒 vs 60 秒之差被仿真的可控随机化进一步放大。 - **视角泛化可以靠渲染解决**。用 Side Frontal 双视角训练后对未见视角的进度从单视角的 30%–33.3% 提升到 **53.5%**。 ## 局限性 论文在 Limitations 中对真实到仿真环节做了完整假设披露并给出了各自的解决方向 1. **依赖物体网格**。跟踪环节使用 FoundationPose需要被操作物体的 3D 网格因此无法处理不知道或没有该物体网格的视频。出路是用 InstantMesh 一类的单图网格估计或从 BEHAVIOR-1K 这类大规模 3D 资产库检索近似网格——仿真只是用来生成数据近似网格即可。 2. **仅限刚性物体**。整条流程以 6D 位姿跟踪为核心天然排除关节物体抽屉、门与可变形物体。前者可以借助视觉先验估计关节参数后者需要粒子式表示。 3. **需要环境 3D 扫描**。仿真场景依赖对环境的显式重建缺少扫描时无法启动。St4RTrack 一类从单目视频同时重建几何与外观的方法配合 Ego4D 这类自带相机运动的数据集是可以去掉扫描要求的路径。 4. **物理参数未估计**。质量、摩擦、刚度一律使用仿真默认值没有从人类视频中辨识。可用视觉语言模型给出类别先验再叠加域随机化更进一步可以把在线标定的框架从**视觉对齐**扩展到**动力学参数**的自监督细化。 作者同时指出本文聚焦从零训练但这套配方可以直接用于微调预训练策略。 ## 常见问题FAQ ### X-Sim 需要采集机器人的遥操作数据吗 不需要。这是全文最核心的主张X-Sim 不需要任何机器人遥操作数据without any robot teleoperation data。唯一的输入是一段 RGBD 人类视频加上环境与物体的三维扫描。整个训练数据都在仿真中生成唯一涉及真机的是部署后为在线标定收集的 10 条策略 rollout而这些 rollout 不需要人工操作也不要求成功。 ### X-Sim 为什么不用逆运动学把人的手映射成机器人的动作 因为那个假设通常不成立。论文指出重定向方法assumes that human movements are feasible for the robot to replicate … which is rarely the case in practice。实验中 Object-Aware IK 在 Kitchen 任务上能到 80% 以上但在 Tabletop 任务上掉到 30%–36.7%正是这一假设失效的直接证据。X-Sim 反过来只要求物体运动一致机器人用什么动作去实现完全自由。 ### 在线自标定的数据从哪来需要标注吗 完全不需要标注也不需要成功轨迹。做法是把训练好的初始策略部署到真机收集其闭环 rollout 的图像观测包含失败然后用 FoundationPose 在第一帧恢复初始状态在仿真中重放完全相同的机器人轨迹从而得到真实与仿真的配对图像。训练时在行为克隆损失之外加一项权重 0.1 的 InfoNCE 对比损失把同状态的跨域嵌入拉近。 ### X-Sim 与传统 sim-to-real 的关键区别是什么 区别在仿真里学什么。RialTo、ResiP 一类工作用仿真做策略鲁棒化或残差精修但仍需要真实机器人数据作为起点Human2Sim2Robot 同样从人类视频出发在仿真里学但推理时依赖精确的 6D 物体位姿跟踪跟踪误差会让策略分布外失效。X-Sim 则用**原始 RGB 图像**作为部署观测——Letter Arrange 任务上图像策略达到 83.3%而位姿策略基线只有 43.3%。 ### 数据效率到底高多少 在高初始状态分布方差的 Mustard Place 变体上X-Sim 用 1 分钟人类视频3 段 × 20 秒达到 90% 成功率而行为克隆用 10 分钟机器人遥操作演示只达到 70%。这是一次测量意义上的 10 倍采集时间优势来源是采集速度20 秒 vs 60 秒与仿真中零成本的状态扰动。 ### 这套方法能直接用在互联网视频上吗 目前还不能。论文在 Limitations 中明确承认its application to unstructured, in-the-wild internet videos remains an open challenge。主要障碍是需要待操作物体的 3D 网格、只支持刚性物体、且需要环境的显式 3D 扫描。作者给出的方向分别是单图网格估计、关节/可变形物体的专门表示以及从单目视频直接重建环境。 ## 参考链接 - 论文 arXiv 摘要页[arXiv:2505.07096 — X-Sim: Cross-Embodiment Learning via Real-to-Sim-to-Real](https://arxiv.org/abs/2505.07096) - 项目主页含代码与视频[portal-cornell.github.io/X-Sim](https://portal-cornell.github.io/X-Sim/) - Diffusion Policy图像条件扩散策略骨干[arXiv:2303.04137](https://arxiv.org/abs/2303.04137) - 2D Gaussian Splatting环境几何重建[surfsplatting.github.io](https://surfsplatting.github.io/) - FoundationPose零样本 6D 物体跟踪[nvlabs.github.io/FoundationPose](https://nvlabs.github.io/FoundationPose/) - Human2Sim2Robot最相关的仿真内学习基线[arXiv:2504.12609](https://arxiv.org/abs/2504.12609) --- 给大家推荐一款自用写文献综述、无虚构文献的 AI **复旦大学 FudanNLP 团队自研 [切问学术](https://qiewenpaper.com/zh?utm_sourcebzkolutm_contentbaishi)** 官网[qiewenpaper.com](https://qiewenpaper.com/zh?utm_sourcebzkolutm_contentbaishi) 覆盖 **3.6 亿篇**可溯源真实中英文文献能自动整合文献观点生成规范综述 还能挖掘研究创新点、复现实验配合视频教学新手快速上手文献综述写作 --- **后记** 博客的关键词集中在编程、算法、机器人、人工智能、数学等等持续高质量输出中。 **讨论QQ群**[白拾的小屋](https://qun.qq.com/universal-share/share?ac1authKeySuzrb5NKb9KulvZxFC8EMFvcd6jgVp%2B%2BnTG8h351HWQorXVfvI1n5QwEX5dlJyThbusi_dataeyJncm91cENvZGUiOiI3NTAzNjU3MDAiLCJ0b2tlbiI6IlpFL2xLaGYxdXU4cWJPT2dJTkY3aExnWHNaQ1UrL3NJbWprenhLZitWUHVVNmhIR1M5SkZrS09SWmxKNlRreksiLCJ1aW4iOiIyMjc1OTYwNDg2In0%3DdatahgymRnqgtjQPGoBKhZ8cEyznp0CMLWfCbG4rfiWIADCArVXw50a7c-Q4MWU2Eq3dwOUjG19hamAWQQU4lY-cOQsvctype4tempidh5_group_info) (750365700) **⭐B站账号**[白拾的物理AI组会](https://space.bilibili.com/98639326)活跃于知识区和动画区 **✨GitHub主页**[YhbCode000](https://github.com/yhbcode000)工程文件
📌 标签: 工业官网 设计趋势 AI 建站 SEO
获取完整报告 → RELATED ARTICLES
推荐阅读

2026/10/16 9:10:45
声明式之后,怎么证明更新策略真的生效了

2026/10/16 9:10:45
Gromacs中QM/MM混合模拟实战:分区、交替优化与避坑指南

2026/10/16 9:10:45
从任务管理到数据洞察:基于 AtomGit 智能体的学习效率分析系统开发实践

2026/10/16 10:06:35
C#数据库入门:双连接模式Winform项目增删改查实战详解

2026/10/16 10:06:35
SAP HANA负载管理实战:从工作负载分类到并发与内存限制的完整指南

2026/10/16 10:06:35
用STM32F407实现1Hz~3MHz频率测量:低频精度与误差控制全解析

2026/10/16 10:06:35
51单片机按键输入与矩阵按键实战:从消抖到状态机设计

2026/10/16 10:06:35
CMS79FT738/736寄存器级开发指南:从Keil C51工程搭建到ADC/PWM时序深挖

2026/10/16 10:01:33
SpringBoot+Vue疫情管理系统开发:前后端分离实战详解

2026/10/16 0:04:49
HCIA-AI V3.5 模拟题库从零搭建:知识点标签、组卷算法与错题分析

2026/10/16 0:04:49
游戏项目Shader清理实战:静态扫描与动态验证双轨并行

2026/10/16 0:04:49
比特币白皮书深度拆解:从双重支付到共识机制的核心设计

2026/10/16 1:17:36
流感时间序列预测实战:ARIMA/LSTM全流程拆解与避坑指南

2026/10/16 1:17:35
影刀RPA新手教程:键盘模拟输入实战——输入文本与模拟按键的区别

2026/10/16 1:17:35
影刀RPA新手教程:阅文起点小说数据采集实战——书籍信息与章节内容

2026/10/16 1:17:35
我发现了一个新思路:用 Remotion + Claude Code 像写代码一样自动化生成短视频

2026/10/15 5:07:59
Windows下 Codex 中 Chrome 和 Computer Use 插件不可用问题排查及解决参考方式:TaoToken 统一 Key 配置与验证
)
2026/10/15 8:10:01